Product manager czy developer: jak w dwa tygodnie zbudowałem własny program
Nie jestem programistą. A jednak zbudowałem własny system, który porządkuje, analizuje i pozwala przeszukiwać moje cyfrowe archiwum. 9 terabajtów danych gromadzonych przez wiele lat. Zdjęcia, filmy, dokumenty, arkusze kalkulacyjne, skany i stare archiwa poczty. Zajęło mi to dwa tygodnie po kilka godzin wieczorami. Jeszcze niedawno nie przyszłoby mi do głowy, że mógłbym stworzyć takie oprogramowanie samodzielnie za pomocą vibe codingu.
Zaczęło się od dawno odkładanych planów uporządkowania cyfrowego archiwum.
Zebrałem przez lata ogromną ilość cyfrowych materiałów, wszystko rozrzucone po dyskach, katalogach i kopiach zapasowych. Niektóre pliki powielone kilkukrotnie, inne ukryte w folderach, których nazwy od dawna przestały cokolwiek mówić.
Wiedziałem, że gdzieś mam konkretny dokument, zdjęcie albo dawną korespondencję dotyczącą projektu. Problem polegał na tym, że znalezienie czegokolwiek potrafiło wymagać przeglądania dziesiątek katalogów na różnych dyskach, a czasem nadzieja, że zostało to gdzieś w chmurze, była jedyną szansą na odnalezienie zguby.
Zacząłem szukać programu, który rozwiąże mój problem. Takiego, który znajdzie duplikaty i kolejne wersje dokumentów, identyfikując różnice, opisze fotografie i przeanalizuje nagrania wideo, otwierając wszystkie pliki stworzone w różnych programach na przestrzeni lat.
Najlepiej, gdybym mógł wszystko przeszukiwać tak jak Google. Wpisuję kilka słów opisujących to, czego potrzebuję, i otrzymuję wyniki niezależnie od tego, czy informacja znajduje się w dokumencie Worda, arkuszu Excela, mailu sprzed kilkunastu lat, zeskanowanej fakturze czy na filmie. I oczywiście zrobi to lokalnie, na moim komputerze, bez konieczności wysyłania prywatnego archiwum na zewnątrz.
Szybko okazało się, że istnieją aplikacje realizujące poszczególne funkcje, ale żadna nie odpowiada dokładnie na moje potrzeby. Pomyślałem, czy ze wsparciem AI sam będę mógł przygotować takie rozwiązanie.
Od pomysłu do pierwszej linijki kodu.
Zawodowo od lat zajmuję się rozwojem produktów. Potrafię definiować wymagania, projektować funkcjonalności, oceniać rozwiązania i prowadzić projekty od pomysłu do wdrożenia. Ale programowanie nigdy nie było moim zawodem.
Oczywiście, tak jak większość z nas, korzystam na co dzień z narzędzi AI. Wiedziałem, że potrafią pisać kod, ale czym innym jest wygenerowanie prostego skryptu, a czym innym zbudowanie systemu, któremu zamierza się powierzyć wieloletnie archiwum.
Postanowiłem spróbować i projekt nazwałem FileIndexAI.
Jedną z pierwszych decyzji było określenie, co chcę osiągnąć i jaki efekt na końcu mam otrzymać od narzędzia. To akurat moja codzienna praca, tyle że tym razem to ja byłem klientem. Oczekiwałem, że będę mógł wyszukiwać naturalnym językiem dokumenty i multimedia na podstawie ich treści, a nie tylko nazwy. Następnie zaczęła się praca nad odczytywaniem starych formatów dokumentów, wykrywaniem duplikatów i wyszukiwaniem obrazów oraz wideo na podstawie informacji, jakie zawierają.
AI pomagało mi przeanalizować dostępne technologie, zrozumieć ich ograniczenia i przygotować kolejne elementy systemu. Python, lokalne modele językowe, rozpoznawanie obrazów, OCR, bazy danych, wyszukiwanie semantyczne. Wcześniej nie miałem praktycznego doświadczenia w łączeniu ich w jedno rozwiązanie, ale to się zmieniło.
Własne laboratorium AI, bez rachunku za każde pytanie.
W całym przedsięwzięciu pomogła mi możliwość uruchamiania modeli AI bezpośrednio na własnym komputerze przeznaczonym do gier. Mocna karta graficzna, odpowiednia ilość pamięci i lokalne modele AI zmieniają ekonomię takich eksperymentów.
Zamiast wysyłać tysiące zdjęć, dokumentów czy setki godzin nagrań do komercyjnych usług i płacić za każde kolejne wywołanie API, mogłem wykonywać znaczną część analiz lokalnie. To miało ogromne znaczenie na początku projektu, kiedy jeszcze nie wiedziałem, czy po kilku dniach go nie zamknę z powodu braku kompetencji lub zbyt wysokich kosztów.
Kiedy próbujemy stworzyć coś nowego, nie wiemy, czy pomysł w ogóle zadziała. Ile razy trzeba będzie zaczynać z nowym podejściem. Na tym etapie człowiek częściej popełnia błędy niż odnosi sukcesy. A każda pomyłka wymaga następnego startu.
Gdy każde takie podejście generuje koszty zewnętrznego API, eksperymentowanie szybko może stać się drogie.
Lokalne modele pozwalają podejść do tego inaczej. Mogę testować, zmieniać parametry, uruchamiać kolejne próby i uczyć się na błędach, bez kosztów za każdą kolejną próbę. Co prawda swoje koszty trzeba ponieść, ale może nie wszystkie w jednym momencie. Jak już jest komputer z kartą graficzną z wystarczającym VRAM, to już bez większych obciążeń koszty energii można ponosić bez niepewności, jaki rachunek za korzystanie z API pojawi się na koniec miesiąca.
Chmura do pracy, własne dyski do archiwum.
Przy okazji projektu zmieniłem jeszcze sposób korzystania z chmury. Przez lata coraz więcej danych trafiało na OneDrive i Dysk Google. To wygodne rozwiązania, ale gdy chmura zaczyna pełnić funkcję magazynu tego, co kiedykolwiek w przeszłości stworzyliśmy, zaczyna być nieusprawiedliwione. Im więcej danych, tym większego pakietu potrzebujemy. Z czasem zwykła wygoda zamienia się w kolejny stały koszt, który trudno ograniczyć.
Postanowiłem rozdzielić dwie funkcje.
W chmurze zostawiam materiały, nad którymi pracuję oraz dokumenty, do których potrzebuję bezpiecznego dostępu z różnych miejsc i urządzeń.
Natomiast historyczne archiwa, stare projekty, dawna korespondencja, zdjęcia i filmy przeniosłem do lokalnego systemu. Nie potrzebuję przecież stałego dostępu z telefonu do każdego pliku zgromadzonego przez ostatnie 25 lat.
Chmura pozostała moim narzędziem do pracy, jednak przestała być bezterminowym magazynem całej cyfrowej przeszłości.
Praca z AI nie gwarantuje bezbłędnego kodu.
Najbardziej pouczające były sytuacje, w których wszystko teoretycznie działało, ale rezultat był nieprawidłowy. Pamiętam test wyszukiwania konkretnego zdjęcia. System wcześniej przeanalizował fotografię i poprawnie opisał jej zawartość. Na zdjęciu była osoba trzymająca psa na rękach na plaży. Opis znajdował się w bazie danych, a mimo to wyszukiwarka nie potrafiła znaleźć fotografii. Okazało się, że jeden z modułów zapisywał informacje w miejscu, którego drugi moduł nie przeszukiwał.
Niektóre operacje trwały godzinami. Przy dużej liczbie plików nawet pozornie drobny błąd oznaczał ryzyko powtarzania ogromnej ilości pracy. Musiałem nauczyć się nie ufać bezwarunkowo kodowi wygenerowanemu przez AI.
Model potrafił z przekonaniem proponować rozwiązania, które po uruchomieniu nie działały. Czasem poprawiał nie ten fragment, który rzeczywiście powodował problem. Innym razem rozwiązanie działało na kilku testowych plikach, ale zawodziło przy większej skali. Z czasem zmieniłem sposób pracy. Zamiast prosić AI o stworzenie kolejnej funkcji i od razu uruchamiać ją na całym archiwum, zacząłem wymagać testów, kontroli wyników, punktów przywracania i możliwości wznowienia przerwanej operacji.
Wprowadziłem zasadę, że przenoszenie danych, ich indeksowanie oraz ewentualne usuwanie nadmiarowych kopii to odrębne procesy. Każdy musi dać się zweryfikować.
Wyszukiwanie semantyczne: po treści, nie po nazwie pliku.
Najbardziej zależało mi na wyszukiwaniu po zawartości, nie tylko po nazwie, chciałem wpisywać zapytania zwykłym językiem, zwłaszcza zdjęć, wideo oraz skanów dokumentów. Z plikami tekstowymi można to było robić znacznie prościej dostępnymi w Windows narzędziami, ale ja chciałem combo.
Nie muszę wiedzieć, czy szukana informacja znajduje się w PDF-ie, pliku tekstowym, na zdjęciu czy w starym archiwum pocztowym. To właśnie z myślą o takich sytuacjach rozwijam swój system indeksowania i wyszukiwania.
W przypadku zeskanowanych dokumentów najpierw trzeba rozpoznać tekst, a dopiero później można go indeksować. W arkuszach kalkulacyjnych oprócz samych wartości ważne bywają ich wzajemne zależności. Archiwa pocztowe z kolei wymagają uwzględnienia nadawców, dat, treści wiadomości i załączników.
W przypadku fotografii lub wideo AI analizuje ich zawartość i przygotowuje opis kontekstu i szczegółów zdjęcia. Pozwala odnajdować nawet małe detale w plikach multimedialnych. W archiwum mam zarówno kilkusekundowe nagrania, jak i materiały trwające kilkadziesiąt minut, a nawet wiele godzin. Ich ręczne przeglądanie w poszukiwaniu konkretnego fragmentu byłoby koszmarem.
Polska gramatyka nie odpuszcza. Wpisuję w wyszukiwarkę „pies”, a w opisie zdjęcia jest „kobieta trzymająca psa”. Wyszukiwarka musi wiedzieć, że to to samo słowo, inaczej nie znajdzie nic. Odmiana to jednak nie wszystko, ciężej jest ze słowami, które wyglądają podobnie albo sprowadzają się do tej samej formy podstawowej, a znaczą coś zupełnie innego. Szukam zdjęć z „lodami”, a system sprowadza je do „lodu” i pokazuje zamarznięte jezioro. Wpisuję „koszty”, a dostaję zdjęcia „koszy”. I tu poznałem nowe słowo (tak, nie znałem go wcześniej): „lematyzacja”. Od niej zależało, czy wyszukiwarka znajdzie za mało, czy za dużo.
Lokalna wyszukiwarka plików: co udało się zbudować?
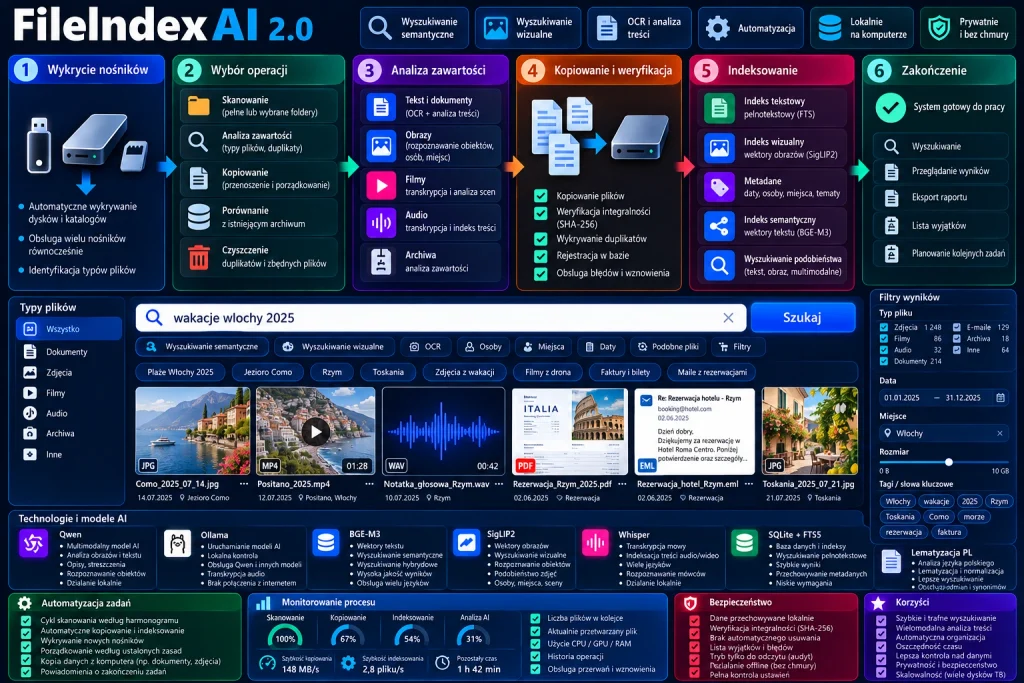
FileIndexAI działa na moim komputerze i nie potrzebuje zewnętrznego serwera do analizy zawartości archiwum. Korzysta z lokalnych modeli, między innymi Qwen3-VL do analizy obrazów i Whisper do rozpoznawania mowy. Ponadto działa wyszukiwanie pełnotekstowe FTS5 w SQLite i semantyczne BGE-M3. Dane i wyniki analiz trafiają do lokalnej bazy.
Trochę statystyki:
– OCR przetworzył 1435 zeskanowanych PDF-ów, prawie pięć tysięcy stron, bez błędów.
– System przygotował opisy ponad 166 tysięcy zdjęć w różnych formatach.
– W jednej z sesji usunął ponad 22 tysiące duplikatów i zwolnił 111 GB miejsca na dysku.
– W sumie 9 TB danych zostało zaindeksowanych i zarchiwizowanych.
FileIndexAI nie jest produktem, który uznałem za skończony. Jest działającym systemem, do którego dokładam kolejne funkcje i który nadal testuję.
Zbudowałem program pracujący na prawdziwych danych, ze wszystkimi problemami, jakie te dane potrafią sprawić, ale działa, wyszukuje i pierwszy raz od wielu lat wiem, co mam i ewentualnie, gdzie tego szukać.
Nie trzeba być programistą. Ale trzeba wiedzieć, czego się chce.
Po tym doświadczeniu patrzę zupełnie inaczej na możliwości tworzenia własnych narzędzi. Niedawno pomysł na aplikację oznaczał konieczność znalezienia programisty lub zewnętrznej firmy, która podejmie się realizacji projektu. Dochodziły koszty i niepewność, czy gotowy produkt rzeczywiście spełni oczekiwania.
Dzisiaj wiele takich pomysłów można samemu sprawdzić i bardzo szybko doprowadzić do działającej wersji, oczywiście mierząc siły na zamiary. Wersji Enterprise w taki sposób nie zbudujemy.
Co ważne, nie zawsze opłaca się budować coś samemu. Jeżeli istnieje gotowy, niedrogi i dobrze działający program, korzystanie z niego może być znacznie rozsądniejsze. Własne rozwiązanie trzeba przecież non stop serwisować, choćby po to, aby było bezpieczne.
AI w marketingu i product managemencie?
Tutaj dotykam już mojej działki zawodowej. Jeżeli potrafiłem zbudować system analizujący ogromne archiwum różnorodnych danych, to dlaczego małe organizacje miałyby ograniczać się do narzędzi, które ktoś wcześniej zaprojektował dla marketingowców czy product managerów? Możemy z takiego podejścia stworzyć alternatywę do wdrażania lokalnych narzędzi dla działów czy małych unitów biznesowych, które mają bardzo specyficzne potrzeby.
Jeśli mogę przygotować aplikację do śledzenia trendów produktowych, analizowania opinii klientów czy porównywania konkurencyjnych ofert, to już duża część codziennej marketingowej pracy mi odpada. Nie muszę zaczynać od szukania gotowej usługi abonamentowej ani od pytania, czy producent przewidział taką czy inną funkcjonalność.
Mogę określić, jak dokładnie ma działać narzędzie, sprawdzić dostępne technologie i zbudować wersję, którą następnie przetestuję na rzeczywistym problemie, i jeśli wszystko się zepnie, moje działania będą bardziej efektywne.
Jeśli rezultat okaże się niezadowalający, to zmodyfikuję to narzędzie albo je porzucę, zanim wydam poważne pieniądze.
Nie muszę też tworzyć rozwiązania uniwersalnego. Wystarczy, że będzie dobrze wykonywało pracę na małym odcinku, której akurat potrzebuję.
Co z tego wynika?
Z FileIndexAI wyniosłem więcej niż działający program. Przekonałem się, że znajomość języka programowania nie musi już być warunkiem rozpoczęcia pracy nad własnym oprogramowaniem. Znacznie większe znaczenie niż wcześniej ma umiejętność opisania problemu, krytyczna ocena proponowanych rozwiązań i systematyczne testowanie efektów pracy, bez przyjmowania każdego rezultatu czy rekomendacji od AI jako potwierdzonego, ostatecznego wyniku.
AI dało mi dostęp do kompetencji, których sam nie posiadałem, w formie pozwalającej wykorzystać je do realizacji własnego pomysłu. Kosztowało mnie to trochę czasu, eksperymentów i frustracji. Czy zrobiłbym to ponownie? Tak. Choć drugi raz zapewne popełniłbym znacznie mniej błędów.
Przez większość kariery zawodowej pracowałem nad produktami tworzonymi przez zespoły specjalistów. Dziś nadal doceniam ich kompetencje, tyle że coraz więcej pomysłów mogę najpierw zweryfikować sam, bez organizowania całego projektu i angażowania dodatkowych zasobów.
Kiedyś, mając pomysł na narzędzie, zastanawiałem się: „Czy istnieje program, który to potrafi?”. Dzisiaj pytam: „Jak chciałbym, żeby działał mój własny?”.
Dodaj komentarz